
‘AI is subjectief en het verleden bepaalt de toekomst, daar moeten we alert op zijn’
Cynthia Liem is multibegaafd, als pianist (op YouTube in The Classical Talent Finale met Magma Duo) en onderzoeker aan de TU Delft. Ik leerde haar kennen tijdens het Nationale Privacy Congres in november 2023 waar ze een voortreffelijke presentatie gaf. Naar aanleiding daarvan vond onderstaand vraaggesprek plaats
We spreken u direct na de verkiezingen van november 2023, gewonnen door de PVV, een onvermijdelijk onderwerp. Emoties en impulsen waren dominant. Stel, je maakt met AI-bots betere stemhulpen en uitkomsten worden direct in stemmen omgezet, kom je dan tot een andere uitslag?
“Inderdaad domineren emoties en impulsen. Een achtergrond van maatschappelijke onvrede, onbehagen en afstand speelde de afgelopen verkiezingen mee. Maar ik vrees dat mogelijke rationalisering via AI alleen maar meer afstand zou creëren. Wie zou de AI-bot programmeren, met welke grootschalige trainingsdata?
Eventueel zou je AI kunnen inzetten om de impact van mogelijke coalities beter te duiden, in combinatie met de CPB-doorrekeningen. Al is ook hier de vraag hoe rationeel en datagedreven coalitievorming in de praktijk is.”
In een college over algoritmes voor Universiteit van Nederland vraagt u “Typ als zoekopdracht ‘partijprogramma’, zonder enige context.” Mensen krijgen heel verschillende zoekresultaten, met politieke invloed tot gevolg. De recent aangenomen AI Act vereist menselijke tussenkomst bij uitkomsten. Maar bij het invloedrijkste algoritme, dat van Google Search, controleert geen mens de totstandkoming van resultaten. Is dat kwalijk?
“Google personaliseert en hanteert contextuele informatie. De vraag is of dat schadelijk is. DuckDuckGo personaliseert niet, maar promootte daardoor wel veel sterker de programma’s van populistische partijen, omdat die zich optimaal presenteerden om zonder veel betaalde campagne veel online aandacht te krijgen.”
Boeiend, wat doet een AI Act of ‘human in the loop’ daartegen?
“Ik hoop dat de AI Act, Digital Services Act en de AVG helpen om meer transparantie te geven over totstandkoming van zoekresultaten en suggesties, en de rechten beschermen van zowel eindgebruikers als die ‘humans in the loop’, de mensen die achter de schermen modereren. Wie zijn deze clickworkers in lagelonenlanden, welke instructies krijgen ze en raken zij niet getraumatiseerd?
De kernvraag luidt: wie bepaalt de uitkomsten van AI-toepassing en hoe? Ik hoop dat behalve handhaving van regulering hier veel publieke dialoog over ontstaat over afwegingen. Enerzijds dreigt censuur van harde regulering, anderzijds een libertarisch model met dominante populistische uitingen. Wat willen we als maatschappij?”
Waarom is de huidige AI-dialoog niet adequaat?
“AI begon als onderzoek naar het modelleren van intelligentie. Hierin zat veel filosofie over de aard van intelligentie en van mensbeelden, plus kennis van cognitie. Computers beginnen als tabula rasa, hoe zou intelligentie ontstaan met welke kennis?
Inmiddels is AI industrieel georiënteerd, gericht op toepassingen. De fundamentele discussie wordt overruled door de race om met massale data en rekenkracht met producten zoals ChatGPT commercieel te winnen. De intelligentie wordt voetstoots hoog geprezen, terwijl de aantrekkelijkheid meer zit in de brede praktische mogelijkheden. Ter vergelijking, een zakmes is aantrekkelijk gereedschap vanwege veelzijdig nut, maar niet intelligent.”
Toch is er een ethische discussie die bij aanvang van sociale media volkomen ontbrak. Is dat dan onvoldoende?
“Dat debat is goed en nodig, maar onvoldoende. Hoe gaan we om met private en publieke belangen? Veel onderzoekscollega’s vertrokken naar industriële partijen voor hogere salarissen en meer data en infrastructuur dan ik bij de universiteit geniet. Bovendien zijn bedrijven beter vertegenwoordigd in lobby’s, waardoor hun perspectief op data van de publieke sector overheerst. Kijk maar eens naar de rol van Microsoft bij OpenAI dat aanvankelijk door publieke belangen leek te worden gedomineerd.”
Ander onderwerp: uw fundamenteel onderzoek, bijvoorbeeld categorisering van voedsel in sociale media met behulp van AI…
“Als je aan een AI-toepassing om het recept van een pizza vraagt, krijgt je als resultaat de pizza zoals de gemiddelde Amerikaanse pizzabezorger die kent en niet de originele Napolitaanse pizza. Categorisering is immers gestoeld op subjectieve sociale en culturele fenomenen en niet op objectieve natuurwetten. De ontwikkelaars van AI nemen dat niet mee; zij pakken de data die ze tot zich krijgen en vertalen die statistisch tot patronen. Met in het geval van de pizza als uitkomst dat je een fastfoodproduct krijgt voorgeschoteld dat niet bepaald in de schijf van vijf past.”
Die pizza is wellicht onschuldig, maar radicaliserende filmpjes zijn dat niet; zeker niet in oorlogstijden. De selectiealgoritmes van TikTok zijn erop ingericht dat mensen worden meegezogen in wat ze gepresenteerd krijgen. Maar de algoritmes van TikTok kennen geen principieel verschil tussen een hobby of een wapen. Fijn voor de wapenindustrie, maar voor het algehele welzijn van de mensheid wellicht niet.”
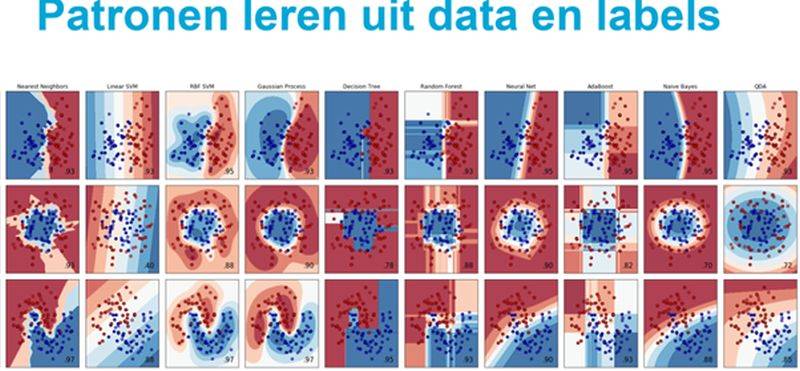
U toont in presentaties een schitterend beeld van verschillende mogelijkheden om uitkomsten van (AI)selecties als blauwe en rode stippen over een vlak te categoriseren. De uitkomst of het patroon hangt af van de principes die worden gekozen om selecties te maken. Is dat de essentie van risico’s rond onverantwoorde AI-inzet?
“Alles in AI-toepassingen, hoe complex ook, wordt in data vertaald, wat leidt tot ‘meet-framing’: alles krijgt een nummertje, meestal in één dimensie, soms meer. Dus je beperkt de complexiteit ten behoeve van heldere en gunstig te exploiteren uitkomsten
Altijd vindt reductie en limitatie plaats, het platslaan van criteria die tot de uitkomsten leiden. Het aanbevelingssysteem van TikTok lijkt bijvoorbeeld te optimaliseren op hoe lang je ergens naar kijkt zonder door te scrollen. Deze grote fenomenen die tot de een uitkomst leiden, beseffen mensen onvoldoende.”
Wat kan er dan misgaan?
“Heel veel. Ten eerste wordt de ideale gebruiker van TikTok en concurrenten een verslaafde gebruiker. Ten tweede is de selectie die je voorgeschoteld krijgt geheel gebaseerd op wat eerder is bekeken. Statistisch machineleren is fundamenteel gestoeld op trainen en evalueren op bestaande data. Het succes zit dus in de bevestiging van eerder geobserveerd succes. Hier speelt dan het risico dat dominante wereldbeelden nog meer de minder dominante overheersen; zie het pizza-voorbeeld.”
Ik vrees een trechter, terecht?
“Precies! Cultuurgevoelige, creatieve mensen zullen wellicht nog actief naar andere perspectieven en nieuwe interesses zoeken. Maar velen zullen niet doorhebben wat ze mislopen, omdat ze tevreden zijn met wat ze krijgen. Kritisch nadenken en afwijken van een makkelijk herkenbare norm erodeert, omdat we zo snel en gemakkelijk bij die herkenbare norm terechtkomen.”
Kun je dat voorkomen door elementen van verrassing in te bouwen?
“Dat kan natuurlijk, maar kost extra inspanning. Bovendien, voorspelbaar gedrag levert commerciële partijen meer op. Voor hen is het niet gunstig als je telkens van voorkeur verandert. Het is lucratiever en efficiënter om gedrag van mensen te uniformeren.”
Ik suggereerde al eens dat Facebook mij geen nieuwe vrienden vanuit kringen dichtbij moet aanbevelen, maar mensen in Thailand en Congo die mij nieuwe inzichten bieden, wellicht met voorkeuren die bij mij passen…
“Dat is interessant, maar hier zijn platforms heel bang voor. Dit soort aanbevelingen zullen minder makkelijk herkenbaar zijn voor hun klanten, met als risico dat die minder tijd doorbrengen op het platform of zelfs overstappen naar de concurrent. Het kost moeite om minder herkenbare aanbevelingen te accepteren, en ook om andere culturen goed te begrijpen.
Bovendien menen wij, de klanten, de wereld al goed te kennen. Bij een beursaanvraag voor onderzoek naar smaakverbreding via AI zei een jurylid mij ooit stellig: ‘Mensen weten zelf wel wat ze leuk vinden, waarom zou je die smaakverbreding willen onderzoeken?’
Dat was nota bene een academicus. Maar hoeveel in de catalogus van een Netflix of Spotify zien we niet, terwijl het misschien wel degelijk de moeite waard is?"
U vraagt mensen online om mee te doen aan AI-testen. Ze moeten studenten toelaten op grond van eindexamencijfers en het resultaat van een motivatietoets. En hun een lening verstrekken op grond van hun vermogen op de bank en het voorheen trouw terugbetalen. Wat toont dit aan?
“Precies waarover dit interview nu gaat: uitgaan van statistisch bewezen waarheid, waarop alle keuzes in de toekomst lijken. Het lijkt volkomen rationeel om studenten te selecteren en leningen te vergeven op grond van deze criteria. En om dus AI-systemen daarop in te richten. Is dat ook zo? Ik wil daarvoor bewustzijn krijgen bij een breder publiek.”
Logisch toch dat bijvoorbeeld ambtenaren die een systeem opzetten om subsidies of uitkeringen te verstrekken uitgaan van rationele criteria die zich in het verleden hebben bewezen?
“Ja, maar de eenzijdig rationele beleidskant miskent een ideologische kant. Wil je mensen met een hoger inkomen makkelijker lenen en verschillen met armen vergroten? Krijgen dezelfde bevoorrechte studenten medicijnen op grond van slechts twee criteria? Zo neutraal is die beoordeling op deze criteria niet.
Idem dito in risicomodellering voor fraudedetectie die vanuit het oogpunt van de handhaver logisch klinkt. Succes wordt gehanteerd als bevestiging, terwijl dit ongezien onrechtvaardigheid creëert. In het verleden behaalde successen worden dan bepalend voor de toekomst. Bouw je bijvoorbeeld AI voor de selectie van leiders op grond van eigenschappen van succesvolle leiders nu; veelal 50-plus mannen met veel oog voor goede kwartaalresultaten?”
Mensen vertonen die vooroordelen en risicomijding toch ook, net als AI?
“Als vrouw in de technische wetenschap ervaar ik dat zeker. Mensen willen herkennen. We moeten mensen die keuzes maken voor AI-programma’s deze spiegel voorhouden, dat ze te comfortabel selecteren. We moeten ze stimuleren om in andere richtingen te zoeken.”
Dus we kunnen bevooroordeelde menselijke intelligentie juist helpen met kritische en perspectiefverbredende AI?
“Absoluut, als we ons daar actief voor openstellen. Gaat een product als ChatGPT dit waarmaken? De belofte is een persoonlijke assistent, maar er wordt vooral plausibele taal gegenereerd, en als we niet uitkijken klinken en zeggen we dan allemaal hetzelfde door klakkeloos over te nemen wat is gegenereerd. Al kun je het ook gebruiken om op eerste gedachten te komen, waarbij wij die gedachten dan proactief zelf verder kunnen uitwerken.”
In het verlengde hiervan heeft u publiekelijk commentaar gegeven op risicomodellering. U spreekt over definities van eerlijkheid die onderling wiskundig conflicteren. Hoe bedoelt u?
“We weten dat de wereld vaak oneerlijk is, met ongelijkheid, onzekerheid, gebrekkige diversiteit. Voor algoritmische metingen van eerlijkheid, heb je een algoritmische, dus wiskundige definitie nodig van hoe je eerlijkheid interpreteert. Maar er zijn veel verschillende definities mogelijk. Sommigen vinden het eerlijk als achtergestelden in de maatschappij een extra zetje krijgen. Anderen vinden een ‘rich get richer’-model juist eerlijk. Daar horen andere formules bij en fundamenteel andere beleidskeuzes met een fundamenteel andere impact.”
Hoogleraar Peter de Kock, expert in AI voor fraude- en misdaadbestrijding, zegt kortweg dat AI eerlijker is en tot betere uitkomsten leidt dan menselijke intelligentie?
“Hoe definieer je dan eerlijkheid, rechtvaardigheid en succes? In veel controverses rond risicomodellering werd vertrokken vanuit profilering van mensen die bij voorbaat minder werden vertrouwd door de inspecteurs, waarna hun waarheid werd opgeschaald. Het onrechtvaardige van zo’n aanpak is dat mensen die lijken op eerder verdachte mensen sowieso verdacht zijn, terwijl een mogelijke ‘bad actor’ die hier expliciet niet op lijkt aan de aandacht ontsnapt.”
Recent kapittelde WODC-onderzoek de veelgeprezen Top-600 criminele jongerenaanpak van ex-burgemeester Van der Laan. Recidive verminderde niet, weging van factoren bleek achteraf onjuist. Menselijk of kunstmatig: intelligentie schoot tekort.
“Deze aanpak vond ik ook al controversieel. Als handhaver heb je met deze aanpak eigenlijk altijd succes. Als een verdachte jongere crimineel wordt, heb je succes omdat het matcht met je verdenking; als een verdachte jongere niet crimineel wordt, boek je succes omdat het programma tot doel heeft om te voorkomen dat jongeren crimineel worden.
Maar wat doet het met een jongere en diens omgeving om expliciet als mogelijke crimineel onder een vergrootglas te liggen? Er is met vergelijkbare investeringen een alternatieve beleidsaanpak mogelijk met constructieve begeleiding, zonder uit te gaan van het frame van verdenking.”
De jaarlijkse Quote 500 lijkt me een namenlijst voor kansrijke AI om belastingontwijking te voorspellen met AI? Kan dat?
“Het publiek roept momenteel om een ferme aanpak van kleine criminaliteit. Mocht je bij de Quote-500 onrechtmatigheid vinden, dan heb je echter wel in een keer meer geld binnen. Maar een AI-aanpak brengt desondanks nog steeds dezelfde risico’s rond aannames en patroonbevestiging mee als eerder besproken…”
*) Een versie van dit vraaggesprek verscheen eerder in iBestuur nummer 49 van januari 2024
**) Foto boven: Marco Borggreve; tweede foto: Peter Olsthoorn

Netkwesties © 1999/2026. Alle rechten voorbehouden. Privacyverklaring
